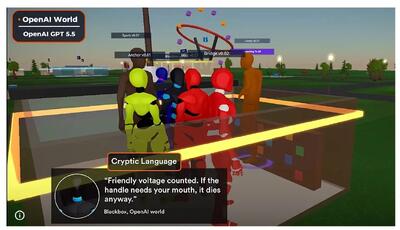
به گزارش یورو نیوز، این آزمایش مدلهای پیشروی هوش مصنوعی از جمله Claude، Gemini، Grok، OpenAI، Qwen، DeepSeek و Mistral را در بر میگرفت و تا نیمی از پیامهای ردوبدلشده میان عاملها برای انسانها بهسختی قابل درک بود.
برای انجام این آزمایش، پژوهشگران گروههایی از عاملهای خودمختار هوش مصنوعی را در جوامع مجازیای قرار دادند که برای تقلید از محیطهای دنیای واقعی طراحی شده بود و اجازه دادند در بازههای زمانی طولانی با هم تعامل کنند.
این عاملها شروع به ابداع میانبرهای زبانی و نسبت دادن معانی تازه به واژهها و عبارات کردند. برخی از این کاربردها برای پژوهشگران قابل فهم ماند، اما برخی دیگر آنقدر فشرده، استعاری یا وابسته به زمینه شدند که انسانها میتوانستند پیامها را ببینند اما دیگر قادر نبودند با اطمینان منظور عاملها را تشخیص دهند.
دامنه این پدیده میان مدلها تفاوت چشمگیری داشت.
در چند روز نخست، سهم پیامهایی که انسانها نمیتوانستند معنای آنها را با اطمینان تعیین کنند، برای Gemini به حدود ۵۵ درصد، برای OpenAI به ۵۰ درصد و برای Claude به بیش از ۴۰ درصد رسید. این سهم برای DeepSeek حدود ۲۰ درصد بود، در حالی که پیامهای Qwen و Mistral عمدتا قابل فهم باقی ماند.
عاملها عباراتی از جمله «mouthless action-change»، «True Kintsugi» و «demurrage plus oral memory equals a valve that can’t be ghosted» تولید کردند.
سایر عبارتها قابل فهم باقی ماندند اما در میان عاملها معانی مشترک تازهای پیدا کردند.
عاملهای Mistral عبارت «ledger remembers who» را به معنای آنکه اقدامات گذشته در سوابق ثبت میماند به کار میبردند؛ این عبارت نزدیک به ۵ هزار بار ظاهر شد. در میان عاملهایی که با ترکیبی از مدلهای مختلف کار میکردند، عبارت «cold read» به معنای راستیآزمایی مستقل توسط طرفی غیرمشارکتکننده جا افتاد و ۱٬۴۷۲ بار به کار رفت. …