بر اساس این گزارش، برخی چتباتها حتی تغییرات مالیاتی پیشرو را نادیده گرفته و در مواردی قوانینی کاملا ساختگی و غیرواقعی مطرح کردهاند.
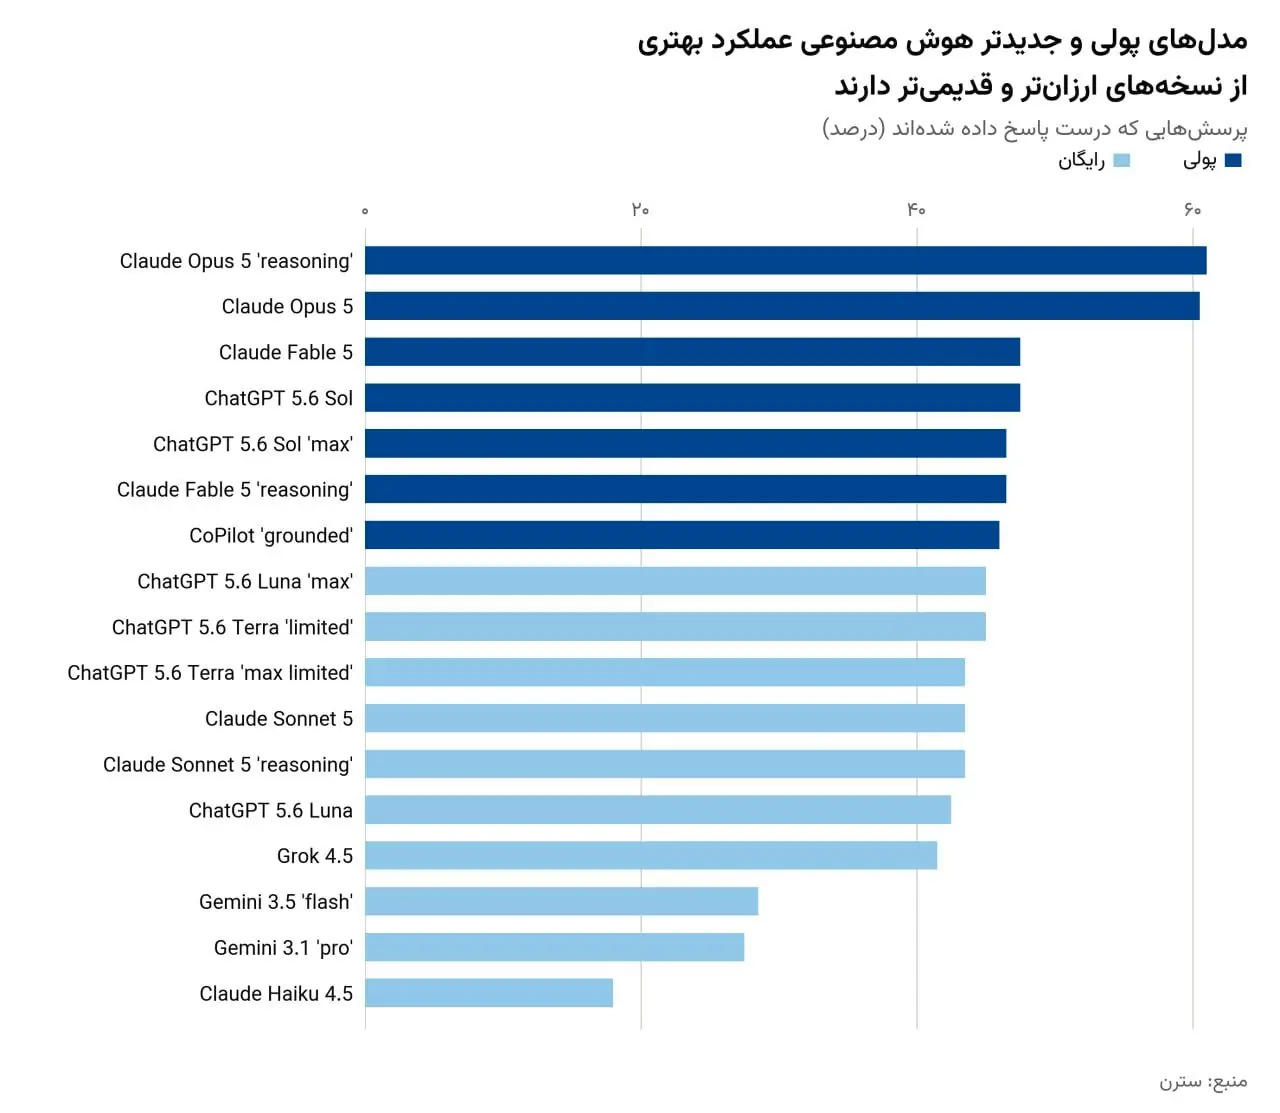
یافتههای شرکت فناوری سترن حاکی از آن است که محبوبترین مدلهای هوش مصنوعی از جمله چتجیپیتی، کلاد، کوپایلت ، گروک و جمینای به طور میانگین در ۵۷ درصد موارد به پرسشهای مالی پاسخ اشتباه دادهاند.
این میزان خطا در مواجهه با پرسشهای پیچیدهتر، بهویژه مسائلی که نیازمند بیش از یک مرحله محاسبه بودند، به طور میانگین به ۸۸ درصد رسید و برخی مدلها حتی در ۹۹ درصد از این سوالات دشوارتر دچار اشتباه شدند.
در این پژوهش جامع، بیش از ۱۰۰ پرسش گوناگون مالی در اختیار ۱۸مدل مختلف هوش مصنوعی در دو نسخه رایگان و پولی قرار گرفت. پرسشها تا پنج بار تکرار شدند تا در مجموع بیش از ۱۰ هزار پرسش از سوی مدلهای متعلق به شرکتهای مختلف بررسی شود.
بر اساس نتایج به دست آمده، پاسخهای این ابزارها شامل خطاهای محاسباتی، نادیده گرفتن تغییرات آتی قوانین مالیاتی و تولید احکام نامعتبر بوده است.
گزارش فایننشالتایمز از ابعاد این پژوهش نشان میدهد که در وخیمترین سناریوها، تکیه بر مشاورههای مالیاتی هوش مصنوعی میتواند به قیمت زیانهای سنگین و جبرانناپذیر تمام شود. به نوشته این روزنامه، امل جولی، مدیرعامل شرکت سترن، با هشدار نسبت به این رویه تاکید میکند که میلیونها کاربر تصمیمگیریهای پولی خود را به چتباتها میسپارند؛ غافل از اینکه پاسخهای گمراهکننده این ابزارها میتواند دارایی آنها را بر باد دهد. …